Was wurde angekündigt?
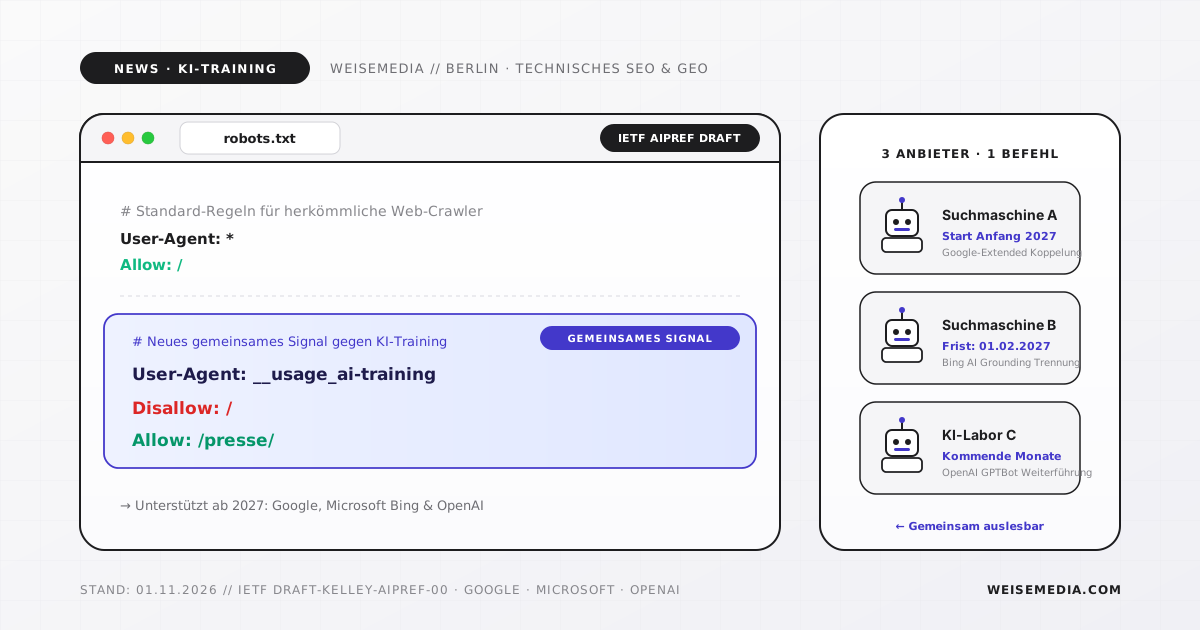
Bisher mussten Website-Betreiber für jeden KI-Crawler separate Regeln hinterlegen, um das Verwenden eigener Inhalte für Modell-Trainings zu steuern. Am 30. Oktober 2026 kündigten Google, Microsoft Bing und OpenAI an, künftig ein gemeinsames Signal in der robots.txt gegen KI-Training zu unterstützen.
Die Initiative basiert auf der AIPREF-Arbeitsgruppe der Internet Engineering Task Force (IETF). Google stellte das Vorhaben im Search Central Blog (Beitrag von John Mueller) vor und nannte in der Crawler-Dokumentation Anfang 2027 als Startzeitpunkt. Microsoft Bing beachtet die Präferenz ab dem 1. Februar 2027 beim Crawlen, während OpenAI eine Einführung in den kommenden Monaten plant.
Fachmedien wie Search Engine Roundtable und PPC Land werten die Einigung als ersten gemeinsamen Standard großer Anbieter im Zeitalter generativer Sprachmodelle.
| Anbieter | Zusage zum Signal | Geplanter Zeitpunkt |
|---|---|---|
| Beachtung des Signals; Disallow ohne Google-Extended-Regel blockiert Google-Extended | Anfang 2027 | |
| Microsoft Bing | Beachtung beim Crawlen; getrennte seitenbezogene Steuerung für Grounding | Ab 01.02.2027 / Frist: 01.03.2027 |
| OpenAI | Beachtung des Signals; bot-spezifische Direktiven (wie GPTBot) bleiben wirksam | Kommende Monate |
Wie funktioniert der neue Eintrag?
Der IETF-Entwurf draft-kelley-aipref-training-preference-signal-00 führt einen sogenannten Policy-Token namens __usage_ai-training ein. Dieser steht wie ein gewöhnlicher User-Agent in der robots.txt:
User-Agent: __usage_ai-training
Disallow: /
Allow: /presse/
In diesem Beispiel wird KI-Training für die gesamte Domain abgelehnt, der Pressebereich jedoch explizit freigegeben. Zwei Punkte aus dem Entwurf sind grundlegend:
Erstens gilt eine Sammelgruppe User-Agent: * ausdrücklich nicht für den Token; er muss eigens benannt werden. Zweitens handelt es sich um kein Crawling-Verbot: Bots dürfen Seiten weiterhin abrufen und indizieren.
Der Entwurf definiert KI-Training als das Anpassen interner Parameter generativer Modelle. Klassifizieren, Indizieren oder Ranken fällt nicht darunter. Der Entwurf ist ein individueller IETF-Draft ohne formalen Standard-Status; Details können sich noch ändern.
Was bedeutet das bei Google und Bing konkret?
Bei Google hat das Signal eine spürbare Nebenwirkung: Trägt eine Domain Disallow für das Token ein und nennt Google-Extended nicht gesondert, wertet Google dies automatisch als Sperre für Google-Extended.
Google-Extended regelt die Datenverwendung für Gemini-Modelle und Grounding in Gemini-Apps sowie Vertex AI. Grounding bedeutet, dass ein generatives Modell Webseiten heranzieht und als Quelle zitiert. Wer das Signal setzt, verliert diese Nennungen, bleibt in der regulären Google-Suche aber unverändert gelistet.
Microsoft trennt Training und Grounding: Das Training wird über robots.txt gesteuert, Grounding über seitenbezogene Metatags. Mit DisallowExtended kann die Zitierung in Copilot erlaubt, für externe APIs aber untersagt werden. Microsoft beachtet das Trainingssignal ab 1. Februar 2027; wer NoArchive oder NoCache nutzt, muss bis 1. März 2027 umstellen.
Was heißt das für Ihr Unternehmen?
Unsere Einschätzung: Das gemeinsame Signal vereinfacht die Rechteverwaltung, bleibt aber eine freiwillige Zusage ohne technische Sperre. Für die meisten Unternehmen überwiegt der Nutzen digitaler Sichtbarkeit in KI-Antworten (GEO) den Schutz vor Trainingsdaten. Unsere Empfehlung:
- 1Ziele klären: Prüfen Sie, ob Sie nur Modelltraining ablehnen oder bewusst auf Zitate in KI-Suchsystemen verzichten wollen.
- 2Robots.txt prüfen: Kontrollieren Sie bestehende Sperren für Bots wie Google-Extended oder GPTBot.
- 3Google-Extended explizit erlauben: Wer Training untersagt, aber Zitate in Gemini wünscht, muss Google-Extended ausdrücklich freigeben.
- 4Bing-Fristen einhalten: Bisherige NoArchive-Regeln bis zum 1. März 2027 auf die neuen Metatags umstellen.
- 5Besonnen vorgehen: Da das Signal erst 2027 greift, besteht kein Grund zu überstürztem Handeln. Bei einer sauberen Next.js-Entwicklung in Berlin oder einem Website-Relaunch pflegen wir Direktiven zentral im Code. Details lesen Sie in unserem Leitfaden zu Google KI-Suche und Quellen-Links sowie zur Sichtbarkeit in KI-Suchen.
ACR Assistenz
High-Performance Next.js Plattform & technische Suchmaschinenoptimierung
Häufige Fragen
Verwendete Quellen & Nachweise
- Google Search Central Blog: Giving publishers more choice with an AI training preference (30.10.2026) — Offizielle Ankündigung von John Mueller zur Unterstützung des gemeinsamen robots.txt-Signals(Abruf: 01.11.2026)
- Google Search Central: Dokumentation zu gängigen Google-Crawlern — Hinweise zu Google-Extended, Trainings- und Grounding-Präferenzen ab Anfang 2027(Abruf: 01.11.2026)
- Microsoft Bing Blog: Your Content, Your Choice – Clearer Preferences for Training and Grounding (30.10.2026) — Erklärung der Fristen ab 01.02.2027 sowie der seitenbezogenen Grounding-Steuerung(Abruf: 01.11.2026)
- IETF Datatracker: draft-kelley-aipref-training-preference-signal-00 (30.10.2026) — Internet-Draft zu Machine-Readable Training Preference Signal und Policy-Token __usage_ai-training(Abruf: 01.11.2026)
- OpenAI News: Helping websites express AI training preferences (30.10.2026) — Bestätigung der Unterstützung des standardisierten Signals für kommende Monate(Abruf: 01.11.2026)
Sie möchten wissen, was Ihre robots.txt heute über KI-Training und KI-Antworten aussagt und ob das zu Ihren Zielen passt? Wir prüfen Ihre Einstellungen und empfehlen eine klare Linie, bevor die neuen Regeln 2027 greifen.
Alexander Weise ist Inhaber von WeiseMedia am Mariendorfer Damm in Berlin. Er konzipiert und programmiert High-End Next.js Plattformen, individuelle CRMs und spezialisierte Webauftritte mit Fokus auf Ladezeit, DSGVO-Sicherheit und Konversion.